
Ein Mac Studio mit 256 GB Unified Memory ist inzwischen die pragmatischste Hardware-Plattform für ein vollständig On-Premise betriebenes RAG-System im Mittelstand. Der entscheidende Trick liegt nicht in der reinen Rechenleistung, sondern in der Kombination aus nativem Metal-Zugriff für das Sprachmodell und Docker-Containerisierung für den Rest der Kette. Dieser Beitrag zeigt ein konkretes, reproduzierbares Setup — Schicht für Schicht.
Die Anforderungen, die in mittelständischen Unternehmen an KI-Systeme gestellt werden, klingen simpel und sind technisch anspruchsvoll zugleich: Die eigenen Dokumente sollen durchsuchbar sein, Rechnungen und Verträge sollen automatisch ausgelesen werden, und dabei darf kein Byte das eigene Haus verlassen. Datenschutz ist dabei kein Zusatzfeature, sondern die Randbedingung, die über die Architektur entscheidet.
Genau hier liegt der Vorteil einer eigenen Hardware: Ein Mac Studio mit 256 GB Unified Memory vereint CPU, GPU und Speicher in einem Adressraum. Das ist die idealtypische Maschine für ein RAG-System, das mit großen lokalen Modellen arbeitet und trotzdem DSGVO-konform im eigenen Netzwerk bleibt — ohne Cloud-Rechnung, ohne Datenabfluss, ohne Latenz über das Internet.
1. Architektur-Übersicht: der Hybrid-Ansatz
Der zentrale Entwurfsentscheidung lautet: das Sprachmodell läuft nativ, alles andere in Containern. Ollama als native macOS-Anwendung erhält damit den direkten Zugriff auf die Metal-API und den vollen Unified Memory, ohne Virtualisierungs-Overhead. Die übrigen Komponenten — OCR-Pipeline, Vektor-Datenbank, Web-Oberfläche — laufen in Docker-Containern, weil sie sich dort isolieren, versionieren und reproduzierbar aktualisieren lassen.
| Schicht | Komponente | Betriebssystem / Laufzeit | Grund |
|---|---|---|---|
| LLM-Engine | Ollama | Nativ auf macOS | Direkter Zugriff auf die Metal-API und den kompletten Unified Memory ohne Docker-Virtualisierungs-Overhead. |
| OCR & Layout | Docling (IBM) | Python / Docker | Präzise Extraktion von Texten, Scans und komplexen Tabellenstrukturen aus PDFs und TIFFs in Markdown. |
| Vektor-DB | Qdrant oder Chroma | Docker-Container | Skalierbare Speicherung und Ähnlichkeitssuche für Text-Embeddings mit persistentem Volume. |
| User Interface | Open WebUI | Docker-Container | Multi-User-Interface im Firmen-LAN/VPN inklusive Rollenverwaltung und RAG-Pipeline. |
Die Gesamtarchitektur im Überblick — Datenquelle, OCR-Pipeline, Embedding-Generator, Orchestrator, Sprachmodell und Vektorspeicher in einem Zug:
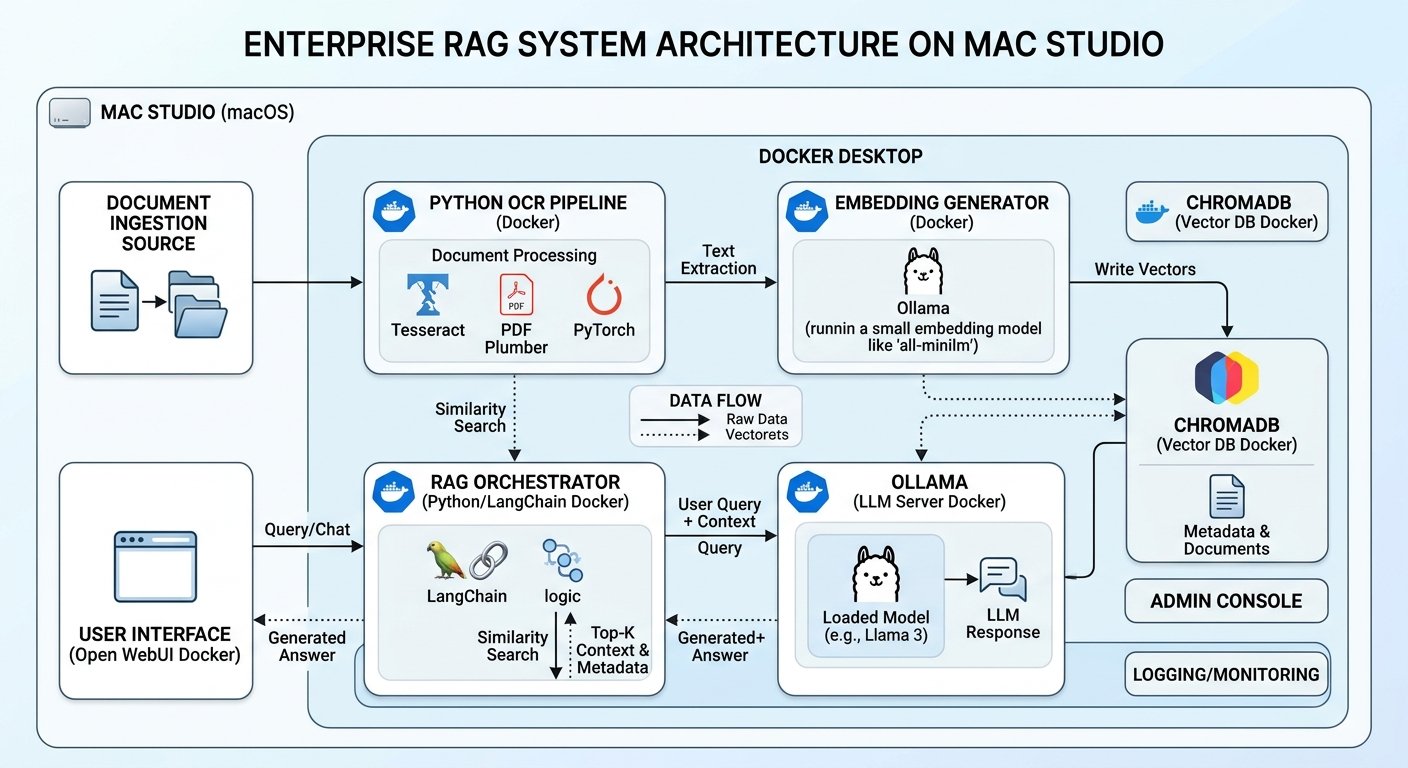
Die Daten fließen dabei immer in einer Richtung: Rohtext aus der OCR-Pipeline wird in Vektoren überführt und in der Vektordatenbank abgelegt; die eigentliche Antwort entsteht erst zur Abfragezeit, wenn der Orchestrator die passenden Top-K-Treffer an das Sprachmodell als Kontext übergibt. Das Modell selbst wird zu keinem Zeitpunkt mit dem Dokumentenbestand trainiert — es erhält ausschließlich den für die konkrete Frage relevanten Ausschnitt.
2. Schritt 1: Ollama nativ auf dem Mac Studio installieren
Ollama wird direkt auf macOS installiert, nicht als Container. Das ist der entscheidende Punkt: Nur nativ hat der Inference-Server direkten Zugriff auf die GPU über die Metal-API und kann den gesamten Unified Memory nutzen, statt durch eine Virtualisierungsschicht hindurch zu arbeiten.
# Nach der Installation über https://ollama.com im Terminal:
# Large Models laden (profitieren extrem von 256 GB RAM)
ollama run qwen2.5:72b
ollama pull nomic-embed-text
Der Embedding-Antwort erfahrungsgemäß taugt das separate, kleine Modell nomic-embed-text. Diese Trennung ist nicht nur sauberer, sie ist auch deutlich schneller: Das Embedding-Modell läuft ohnehin permanent im Hintergrund, während das große Sprachmodell nur dann geladen wird, wenn tatsächlich eine Anfrage kommt. Auf einem Gerät mit 256 GB ist beides parallel problemlos unterzubringen.
3. Schritt 2: Docker-Container bereitstellen
Mit einer docker-compose.yml werden Open WebUI und die Vektor-Datenbank im lokalen Netzwerk bereitgestellt. Die extra_hosts-Konfiguration ist dabei kein Detail, sondern Voraussetzung: Sie erlaubt den Containern, den nativ laufenden Ollama-Dienst über host.docker.internal zu erreichen.
version: '3.8'

services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui
    ports:
      - "3000:8080"
    extra_hosts:
      - "host.docker.internal:host-gateway"
    environment:
      - OLLAMA_BASE_URL=http://host.docker.internal:11434
    volumes:
      - open-webui_data:/app/backend/data
    restart: unless-stopped

  qdrant:
    image: qdrant/qdrant:v1.9.0
    container_name: qdrant
    ports:
      - "6333:6333"
    volumes:
      - qdrant_data:/qdrant/storage
    restart: unless-stopped

volumes:
  open-webui_data:
  qdrant_data:
Container starten:
docker compose up -dDie persistenten Volumes sind übrigens der Punkt, an dem es in der Praxis am häufigsten scheitert. Werden open-webui_data und qdrant_data nicht gemountet, ist nach dem ersten Container-Neustart der komplette Chat-Verlauf und der gesamte Vektorindex verschwunden. Bei einer produktiven Installation gehören diese Volumes zwingend in das Backup-Konzept.
4. Schritt 3: OCR und Dokumenten-Parsing für deutsche Mittelstandsdaten
Für eingescannte Dokumente, Rechnungen und Verträge empfiehlt sich Docling von IBM in Python, weil es Layouts und Tabellen wesentlich genauer versteht als herkömmliche OCR-Werkzeuge. Gerade bei Rechnungen und Verträgen ist das der Unterschied zwischen brauchbarer Extraktion und unbrauchbarem Textmüll: Tabellenspalten, die von klassischer OCR zu einer Zeile zusammengezogen werden, zerstören die semantische Struktur und damit die spätere Embedding-Qualität.
# installation: pip install docling llama-index-embeddings-ollama llama-index-vector-stores-qdrant

from docling.document_converter import DocumentConverter
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader
from llama_index.vector_stores.qdrant import QdrantVectorStore
from llama_index.embeddings.ollama import OllamaEmbedding
import qdrant_client

# 1. OCR & Parsing von Dokumenten
converter = DocumentConverter()
result = converter.convert("rechnung_scan.pdf")
markdown_text = result.document.export_to_markdown()

# 2. Vector Store & Embedding-Anbindung
client = qdrant_client.QdrantClient(host="localhost", port=6333)
vector_store = QdrantVectorStore(client=client, collection_name="mittelstand_docs")
embed_model = OllamaEmbedding(model_name="nomic-embed-text", base_url="http://localhost:11434")

print("Dokument erfolgreich verarbeitet und für RAG bereitgestellt.")
Der Ablauf ist bewusst zweistufig: Docling liefert strukturiertes Markdown, LlamaIndex übernimmt Chunking und Einbettung und schreibt in Qdrant. Wer beide Schritte getrennt hält, kann später das Embedding-Modell austauschen, ohne die gesamte Extraktion erneut laufen zu lassen — ein Rebuild des Vektorindex, der bei zehntausenden Dokumenten sonst Stunden dauert.
5. Schritt 4: Indexierung automatisieren
Für den Produktivbetrieb empfiehlt sich ein Watchdog, der einen Eingangsordner überwacht, neu eingetroffene PDFs erkennt, sie per OCR verarbeitet und automatisch in die Vektordatenbank einspeist. In der Praxis bewährt sich dabei ein Ansatz mit watchdog in Python, der auf FileSystemEvent-Events reagiert und je Datei eine definierte Abarbeitungskette ausführt:
- Ingestion: Datei aus dem Eingangsordner in eine Arbeitskopie verschieben und den Originalnamen als Metadatum festhalten.
- Parsing: Docling-Konvertierung nach Markdown, inklusive Seiten- und Abschnittstrennung.
- Chunking: Abschnittsweise Zerlegung mit Überlappung, damit Fragen nicht genau an einer Grenze abgeschnitten werden.
- Embedding: Über Ollama an das Embedding-Modell, parallelisiert mit wenigen Workern.
- Upsert: Schreiben nach Qdrant unter einer Collection je Dokumentenbereich.
Wichtig ist ein Idempotenz-Key je Datei — in der Regel ein Hash über den Dateiinhalt. Nur so werden bearbeitete Dokumente korrekt ersetzt und Dubletten vermieden, die beim naiven Watchdog-Ansatz sonst zuverlässig entstehen.
6. Datenschutz und Deployment im Firmennetzwerk
Der entscheidende Punkt bei On-Premise-Betrieb ist die Beweislast: Zu keinem Zeitpunkt fließen Daten nach außen. Alle Prozesse laufen offline auf dem eigenen Mac Studio. Konkret bedeutet das:
- Zugriff für Mitarbeiter: Das Web-Interface ist unter
http://<IP-des-Mac-Studio>:3000im Firmennetzwerk erreichbar. - Absicherung: Zugriff über internes VPN (z. B. Tailscale oder WireGuard) oder Reverse Proxy mit TLS/HTTPS (z. B. Caddy oder Nginx).
- DSGVO-Compliance: Keine externen API-Aufrufe, keine Telemetrie in der Modell-Ebene, Backups ausschließlich auf eigenen Datenträgern.
Gerade der letzte Punkt wird in der Praxis unterschätzt. Gerade Open-Source-Werkzeuge und Container-Images verlassen sich gelegentlich auf Standard-Konfigurationen, die Telemetrie oder Upstream-Checks vorsehen. Für einen DSGVO-konformen Betrieb sollte deshalb vor dem Produktivgang explizit geprüft werden, welche ausgehenden Verbindungen das System tatsächlich aufbaut.
7. Betrieb, Wartung und Grenzen
Ein solches Setup ist keine Occasion, sondern eine dauerhafte Betriebslast. Zu den Routineaufgaben gehören:
| Aufgabe | Häufigkeit | Achtung bei |
|---|---|---|
| Backup von Vektorindex und Chat-Verlauf | täglich | Volumes nicht im Container, sondern auf dem Host sichern |
| Modell- und Container-Update | monatlich | Embedding-Modell-Wechsel erzwingt Index-Rebuild |
| Modell-Auswahl nach Anwendungsfall | bei Bedarf | 72B-Parameter-Modelle brauchen spürbar mehr RAM und Antwortzeit |
| Zugriffsrechte und Rollenpflege | quartalsweise | Open WebUI ist ein Multi-User-System mit echten Berechtigungen |
Und die Grenzen? Ein Mac Studio mit 256 GB Unified Memory ist beeindruckend, aber keine Datenbank für Millionen Dokumente. Ab einer bestimmten Menge ist eine dedizierte Vektor-Datenbank auf separater Hardware mit Replikation die vernünftigere Wahl. Und: RAG ersetzt keine Aktualisierung der Dokumente. Ein Vector Store liebt veraltete Daten — er liefert sie nur präzise zurück. Das Qualitätsniveau der Antworten hängt deshalb unmittelbar an der Pflege des Dokumentenbestands, nicht an der Größe des Modells.
8. Fazit
Ein Mac Studio mit 256 GB Unified Memory, nativ betriebenem Ollama und einer Docker-Container-Schicht für OCR, Vektordatenbank und Oberfläche ergibt ein RAG-System, das im Mittelstand real betreibbar ist: hohe Modellqualität, vollständige Datenhoheit, überschaubare Kosten und ein Aufbau, den ein einzelner Administrator nachvollziehen kann.
Die beiden Architekturentscheidungen, die den Ausschlag geben, sind denkbar simpel: Ollama nativ, weil Metal-Zugriff und Unified Memory nur so vollständig genutzt werden — und alles andere containerisiert, weil Reproduzierbarkeit und Update-Sicherheit im Mittelstand wichtiger sind als ein theoretisch optimaler Pfad. Beide Entscheidungen sind in einer Stunde umgesetzt; der Aufwand steckt anschließend in Wartung, Backups und Dokumentenpflege.
Wer sich mit dem Thema beschäftigt, sollte außerdem die verwandten Beiträge im Blick behalten: RAG-Leistungen für den Mittelstand beschreibt die fachliche und organisatorische Seite, Lokale KI mit Ollama die Betriebsseite und KI-Sicherheit im Mittelstand die Risiken, die auch bei einem rein internen System nicht verschwinden.